
Kendala 2: model lokal Ollama tidak bisa dipakai
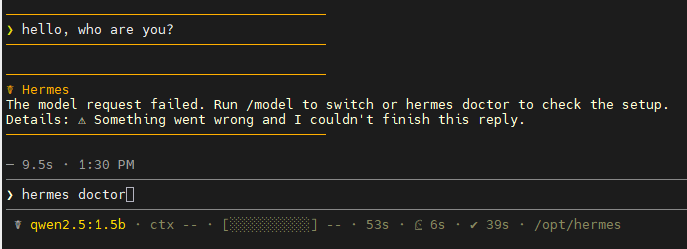
Hermes menolak model lokal saya karena membutuhkan context window minimal 64.000 token. Model kecil yang muat di RAM 2 GB tidak memenuhinya. Urutan yang saya alami:
- deepseek-r1:1.5b tidak mendukung tool calling di Ollama, padahal Hermes sebagai agent membutuhkannya.
- qwen2.5:1.5b mendukung tools, tetapi context-nya hanya 32.768 token. Log Hermes menampilkan
ValueError: ... below the minimum 64,000 required by Hermes Agent. - Memaksa context 64K juga tidak realistis. KV cache-nya saja butuh sekitar 1,8 GB di luar model, dan prompt diproses hanya ±28 token/detik di CPU.
Pelajaran untuk Anda:
- Cek
docker logs hermeslebih dulu saat chat menampilkan “The model request failed”. Pesan error sebenarnya ada di sana. - Jangan pilih Qwen Cloud atau Ollama Cloud di wizard
hermes modeljika maksudnya Ollama lokal. Pilih Custom endpoint dengan base URLhttp://ollama:11434/v1(nama container, bukan localhost) dan mode Chat Completions. - Untuk model lokal yang layak dipakai Hermes, siapkan VPS dengan RAM minimal 8–16 GB dan model ber-context 64K atau lebih.